💡 Abstrakt
Med stærkt specialiserede frontier-kodningsmodeller passer intet enkelt værktøj til alle stak. Inden for det proprietære område udmærker Claude Opus 5.5 sig ved interaktiv debugging, Claude Fable 5.1 driver autonome, langkørende agenter, GPT-6 Astra tackler kompleks samtidighed, og Gemini 4 Argon fører massive repo-refaktorer via enorm gennemløbshastighed. Blandt open-weights-mulighederne muliggør DeepSeek V4 Pro sikker on-premise implementering, Qwen 3.8-Max oversætter visuelle designs til kode, og Kimi K3 understøtter maraton-refaktorer. Den moderne ingeniørstrategi er ikke at vælge én model, men dynamisk at route opgaver på tværs af en arbejdsgang med flere modeller.
Det kan hurtigt føles overvældende at navigere i nutidens overfyldte modeløkosystem for at vælge den bedste LLM til kodning. Når hver ny udgivelse lover 10 gange så høj ingeniørproduktivitet, er det ikke nogen let opgave at finde ud af, hvilken model der rent faktisk leverer i din daglige stak.
For at skære igennem støjen gennemgår denne guide syv AI-kodningsmodeller – herunder Gemini 4 Argon, Claude Opus 5.5, Claude Fable 5.1 og flere. Ved at udpakke deres forskellige styrker og ideelle use cases hjælper vi dig med at finde den bedste AI-model til kodning, der er skræddersyet til din præcise stak.
De bedste LLM'er i kodning
De bedste LLM'er til kodning – et overblik
For at hjælpe dig med at finde den bedste AI-model til kodning, viser tabellen nedenfor, hvordan dagens førende muligheder klarer sig på tværs af vigtige tekniske benchmarks, kontekstbegrænsninger og deres bedste anvendelser i den virkelige verden:
| Modeller | Bedst til | Kontekstvindue | DeepSWE v1.1 | Terminalbænk 4.0 | SWE-Atlas-QnA |
|---|---|---|---|---|---|
| Claude Opus 5.5 | Full-stack agent-workflows, CLI-autonomi (Claude Code) og produktionskvalitets fejlisolering | 1,0 mio. | 68 | 60% | 66 |
| Claude Fable 5.1 | Autonome kodningsagenter natten over, værktøjsorkestrering på flere timer og komplekse migreringer på tværs af hele arkivet | 1,0 mio. | 64 | 55% | 65 |
| GPT-6 Astra | Højkomplekst algoritmisk design, dybdegående samtidighedsfejlfinding og edge-case-ræsonnement | 1,05 mio. | 68 | 60% | 62 |
| Gemini 4 Argon | Storstilede repo-migreringer, tværsproglige omskrivninger og monolitisk kodebase-refactoring | 1,0 mio. | 79 | 57% | 56 |
| DeepSeek V4 Pro | Grænseklasse-ræsonnement til en brøkdel af prisen | 1,0 mio. | 57 | 14% | 62 |
| Qwen 3.8-Max | Autonome flerdages kodningsagenter og kontorproduktivitet | 1,0 mio. | 51 | 32% | 62 |
| Kimi K3 | Frontend og visuel kodning | 1,0 mio. | 68 | 13% | 66 |
Bedste LLM til kodning: Proprietære Frontier-modeller
Til komplekse arkitekturer og missionskritisk kode tilbyder proprietære løsninger uovertruffen præcision. Her er et nærmere kig på fire brancheførende modeller fra Anthropic, OpenAI og Google.
Claude Opus 5.5 & Claude Fable 5.1(Anthropic )
Claude Opus 5.5 og Claude Fable 5.1 , der er udviklet af Anthropic , repræsenterer to forskellige filosofier inden for moderne AI-teknik: den ene er finpudset til samarbejde med udviklere i realtid, og den anden er bygget til autonom udførelse over lang tid.
Claude Opus 5.5 skinner som den ultimative interaktive parprogrammerer. Den er kendt for sin førende terminalflydendehed og arkitektoniske ræsonnement, og den trives i udvikler-i-loop-miljøer som Claude Code – den udmærker sig ved kirurgisk fejlisolering, dynamisk CLI-refaktorering og hurtig produktionsfejlfinding med bemærkelsesværdig præcision.
Claude Fable 5.1 er bygget til uovervågede agentworkflows, der varer flere timer. Den er designet til at køre udvidede loops uden at miste fokus eller afvige logisk, og den udmærker sig ved at orkestrere komplekse værktøjskæder, repo-dækkende migreringer og test-og-reparationscyklusser natten over.
Bedst til
Claude Opus 5.5 udmærker sig ved interaktiv fejlfinding med høje indsatser, lige fra at isolere flygtige produktionsregressioner i terminalen til at guide hurtige refaktoreringer af flere filer sammen med udviklere. Claude Fable 5.1 er bygget til praktiske ingeniørmaratoner, hvor den ubesværet håndterer repo-dækkende afhængighedsopgraderinger og kører uovervågede test-og-reparationsløkker natten over uden afvigelser.
GPT-6 Astra(OpenAI )
GPT-6 Astra, der blev udgivet af OpenAI i september 2026, fungerer som flagskibet inden for teknisk problemløsning med høje indsatser. Udstyret med et kontekstvindue på 1,05 millioner tokens og en outputgrænse på 128K kombinerer det omfattende kodebaseforståelse med OpenAIs hidtil mest stringente ræsonnementarkitektur.
Inden for softwareudvikling er Astras afgørende Edge ren algoritmisk disciplin og præcision under pres. I stedet for blot at producere standardløsninger, udmærker de sig ved at navigere i matematisk kompleks logik, udrede multi-threaded concurrency bugs og systematisk opdage flygtige Edge cases på tværs af missionskritiske systemer.
Bedst til
Missionskritiske systemer og algoritmiske opgaver med nultolerance. Ingeniørteams bruger det til at bygge brugerdefinerede kryptografiske primitiver, finjustere distribuerede tilstandsmaskiner og opspore flygtige samtidighedsfejl i central finansiel eller betalingsinfrastruktur.
Gemini 4 Argon(Google )
Gemini 4 Argon, der blev udgivet af Google i oktober 2026, fungerer mindre som en simpel kodeassistent og mere som en autonom systemarkitekt, bygget til at udforske, ræsonnere igennem og omstrukturere komplekse databaser med minimal vejledning.
Dens enestående fordel er den rene skala: et kontekstvindue på 1 million tokens parret med en banebrydende outputgrænse på 1 million tokens. Dette gør det muligt for Argon at indtage hele kodebaser på én gang og udføre massive refaktoreringer, migreringer af ældre monoliter og dybdegående fejlfinding på tværs af tjenester i en enkelt, uafbrudt proces.
Bedst til
I praksis udmærker den sig ved krævende ingeniøropgaver som at udrede vidtstrakte, ældre monolitter og udføre komplette systemsprogmigreringer. Takket være dens massive gennemløbshastighed kan den spore komplekse fejl på tværs af tjenester og levere komplette refaktoreringer af flere filer i en enkelt gennemgang.
Bedste LLM til kodning: Open Source Frontier Models
At holde din kodebase privat betyder ikke længere, at du skal gå på kompromis med kapaciteten. Nedenfor gennemgår vi tre fremragende kraftcentre inden for åbne systemer fra DeepSeek, Alibaba og Moonshot AI.
DeepSeek V4 Pro(DeepSeek)
Da DeepSeek lancerede DeepSeek V4 Pro i august 2026 under en MIT-licens, tilbød den et ægte alternativ til modeller med indbygget udstyr. Leveret med åbne vægte gav den ingeniørteams intelligens i topklasse, som de kunne inspicere, finjustere og hoste på deres egne præmisser – uden proprietær binding.
Ved tastaturet holder et vindue med 1 million tokens og en slank MoE motor den skarp på tværs af vidtstrakte repositories. Den isolerer regressioner med flere filer med kirurgisk klarhed og driver ubesværet selvhostede kodningsagenter, hvilket beviser, at det at holde din kode privat ikke længere betyder, at du går på kompromis med kapaciteten.
Bedst til
Luftgap i virksomhedsmiljøer og regulerede brancher, hvor proprietær kode ikke kan røre ved eksterne cloud-API'er. Den er ideel til at drive private, selvhostede kodeagenter og udføre omfattende, automatiserede revisioner på tværs af følsomme lokale repositorier.
Qwen 3.8-Max (Alibaba)
Qwen 3.8-Max, der blev lanceret af Alibaba i august 2026, bringer intelligens i frontlinjen til det åbne økosystem. Drevet af en 2,4T MoE arkitektur, der kun aktiverer 95 milliarder parametre på tværs af et vindue på 1 million tokens, kombinerer den dybdegående ræsonnement med friheden til at implementere og finjustere på dine egne præmisser.
Inden for softwareudvikling er dens afgørende Edge parringen af autonom udførelse med native visuel intelligens. Den trives i closed-loop-arbejdsgange – hvor den oversætter UI-mockups direkte til frontend-kode og driver terminalbaserede agentopgaver med minimal menneskelig indgriben.
Bedst til
Multimodal frontend-generering og autonome, closed-loop-arbejdsgange i selvhostede miljøer. Den udmærker sig ved at oversætte visuelle UI/UX-designs direkte til produktionskode og drive terminalbaserede agenter gennem end-to-end test-og-reparationscyklusser.
Kimi K3 (Moonshot AI)
Da Moonshot AI udrullede Kimi K3 i juli 2026, tacklede den den største svaghed ved open-weights-kodning: udholdenhed. Med 2,8T parametre på tværs af et vindue på 1 million tokens klarer den maratonmæssige ingeniøropgaver, der typisk afsporer åbne modeller.
Når den koder, fungerer den mindre som en autofuldførelseswidget og mere som en ægte autonom partner. K3 driver terminalværktøjer, håndterer rodede refaktoreringer af flere filer og bruger native visuel ræsonnement til at fejlfinde UI-regressioner i realtid – med bemærkelsesværdigt lidt håndholdt arbejde.
Bedst til
Maratonomstrukturering på tværs af massive kodebaser og terminaldrevne agentworkflows. Den udmærker sig ved langsigtede tekniske opgaver og visionsstyret UI-fejlfinding med minimal menneskelig overvågning.
HIX AI Chat Agent: Find den bedste LLM til kodning
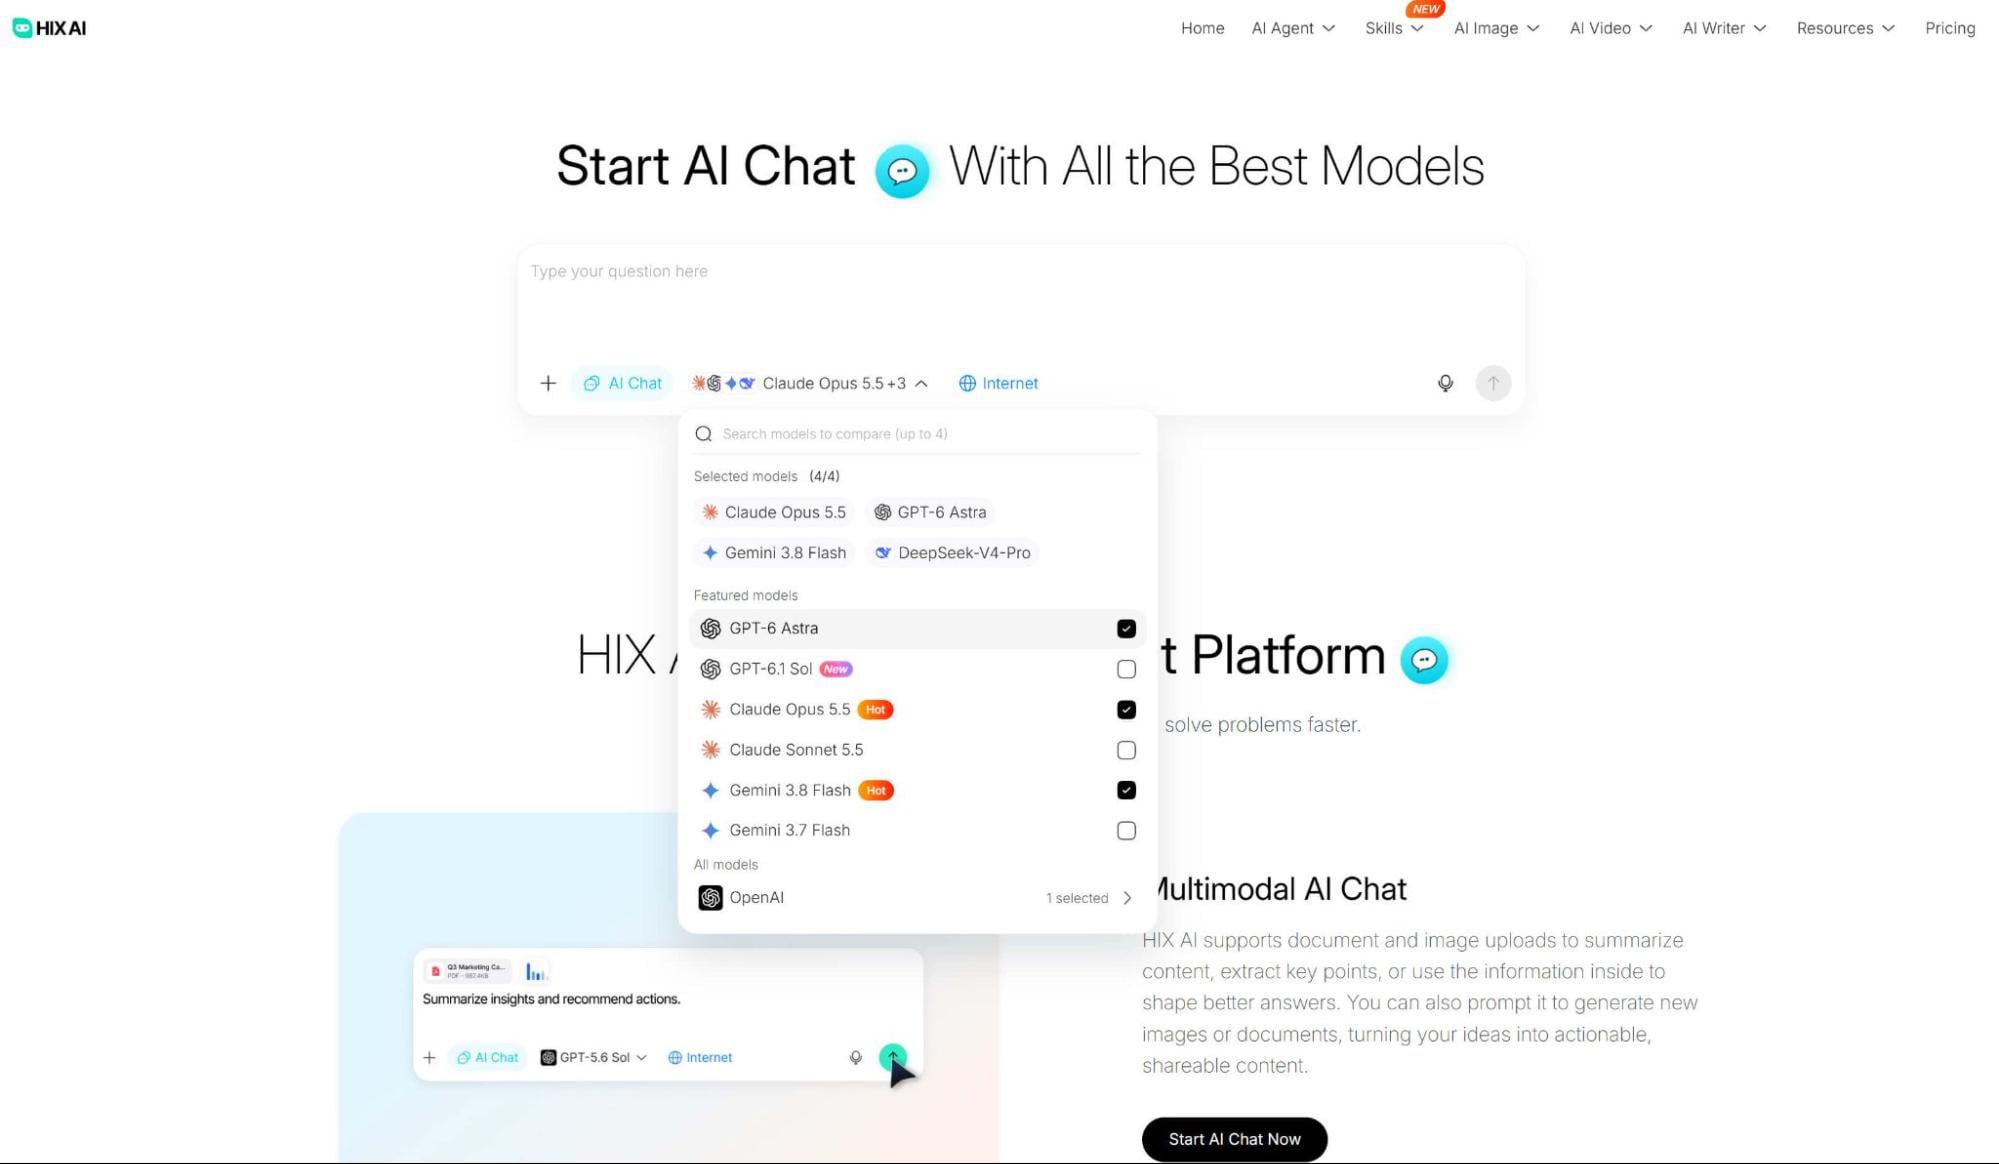
HIX AI Chat Agent forener frontlinjemodeller – inklusive Gemini 4 Argon ,Claude Opus 5.5 , Claude Fable 5.1 , GPT-6 Astra og Qwen 3.8-Max – i ét enkelt arbejdsområde. I stedet for at jonglere med fragmenterede abonnementer får udviklere direkte adgang til branchens skarpeste ræsonnementsmotorer under ét tag.
Dens side-om-side sammenligningstilstand fjerner gætteriet fra modelvalg. Indsend en enkelt kodningsprompt, kør den på tværs af fire modeller samtidigt, og undersøg deres logik og Edge parallelt for at finde den bedste LLM til kodning på få sekunder.
Lige så vigtigt er det, at det giver dig mulighed for at dirigere opgaver til hver enkelt motors naturlige optimale placering. I stedet for at tvinge en universel arbejdsgang frem, kan du tildele Claude til systemarkitekturen, læne dig op ad Qwen til generering af brugergrænseflade til kode eller implementere Gemini til massive kontekstbase-revisioner.
Chat med HIX AI
Konklusion
Realiteten er, at der ikke findes nogen absolut "bedste LLM til kodning". Forskellige ingeniørudfordringer kræver helt forskellige styrker – fra hurtig frontend-prototyping til dybdegående arkitektonisk refactoring. I stedet for at stole på en one-size-fits-all-motor er den smarteste tilgang at evaluere modeller i forhold til din specifikke arbejdsgang for at finde den mest passende AI-model til kodning.
HIX AI gør den beslutning ubesværet. Ved at lade dig visuelt sammenligne svar på tværs af flere førende modeller side om side, fjerner den gætteriet – hvilket hjælper dig med hurtigt at finde den optimale løsning til dine programmeringsopgaver.