💡 Abstrakt
Med svært spesialiserte modeller for grensekoding, passer ikke et enkelt verktøy til hver stabel. Innenfor det proprietære området utmerker Claude Opus 5.5 seg med interaktiv feilsøking, Claude Fable 5.1 driver autonome, langvarige agenter, GPT-6 Astra takler kompleks samtidighet, og Gemini 4 Argon leder massive repo-refaktoreringer via enorm gjennomstrømning. Blant alternativene med åpne vekter muliggjør DeepSeek V4 Pro sikker lokal distribusjon, Qwen 3.8-Max oversetter visuelle design til kode, og Kimi K3 opprettholder maraton-refaktoreringer. Den moderne ingeniørstrategien er ikke å velge én modell, men å dynamisk rute oppgaver på tvers av en arbeidsflyt med flere modeller.
Det kan fort føles overveldende å navigere i dagens overfylte modelløkosystem for å velge den beste LLM-en for koding. Når hver nye utgivelse lover 10 ganger mer ingeniørproduktivitet, er det ingen enkel bragd å finne ut hvilken modell som faktisk leverer i den daglige stacken din.
For å skjære gjennom støyen, bryter denne veiledningen ned sju AI-kodingsmodeller – inkludert Gemini 4 Argon, Claude Opus 5.5, Claude Fable 5.1 og flere. Ved å pakke ut deres distinkte styrker og ideelle brukstilfeller, hjelper vi deg med å finne den beste AI-modellen for koding skreddersydd for din nøyaktige stack.
Beste LLM-er for koding
Beste LLM-er for koding – et overblikk
For å hjelpe deg med å finne den beste AI-modellen for koding, viser tabellen nedenfor hvordan dagens ledende alternativer står seg på tvers av viktige tekniske benchmarks, kontekstbegrensninger og deres beste applikasjoner i den virkelige verden:
| Modeller | Best for | Kontekstvindu | DeepSWE v1.1 | Terminalbenk 4.0 | SWE-Atlas-QnA |
|---|---|---|---|---|---|
| Claude Opus 5.5 | Fullstack-agentarbeidsflyter, CLI-autonomi (Claude Code) og feilisolering i produksjonsklasse | 1,0 millioner | 68 | 60 % | 66 |
| Claude Fable 5.1 | Autonome kodeagenter over natten, verktøyorkestrering i flere timer og komplekse migreringer for hele repositoriet | 1,0 millioner | 64 | 55 % | 65 |
| GPT-6 Astra | Høykompleks algoritmisk design, dyp samtidighetsfeilsøking og kanttilfelle-resonnement | 1,05 millioner | 68 | 60 % | 62 |
| Gemini 4 Argon | Storskala repo-migreringer, omskrivinger på tvers av språk og monolittisk kodebase-refaktorering | 1,0 millioner | 79 | 57 % | 56 |
| DeepSeek V4 Pro | Resonering i grenseland til en brøkdel av kostnaden | 1,0 millioner | 57 | 14 % | 62 |
| Qwen 3.8-Max | Autonome flerdagers kodeagenter og kontorproduktivitet | 1,0 millioner | 51 | 32 % | 62 |
| Kimi K3 | Frontend- og visuell koding | 1,0 millioner | 68 | 13 % | 66 |
Beste LLM for koding: Proprietære Frontier-modeller
For komplekse arkitekturer og forretningskritisk kode tilbyr proprietære løsninger uovertruffen presisjon. Her er en nærmere titt på fire bransjeledende modeller fra Anthropic, OpenAI og Google.
Claude Opus 5.5 og Claude Fable 5.1 (Antropisk)
Claude Opus 5.5 og Claude Fable 5.1, utviklet av Anthropic, representerer to forskjellige filosofier innen moderne AI-teknikk: den ene er finslipt for samarbeid med utviklere i sanntid, og den andre er bygget for autonom utførelse over lang tid.
Claude Opus 5.5 skinner som den ultimate interaktive parprogrammereren. Den er kjent for sin kategoriledende terminalflyt og arkitektoniske resonnement, og trives i utvikler-i-loop-miljøer som Claude Code – og utmerker seg med kirurgisk feilisolering, dynamisk CLI-refaktorering og rask produksjonsfeilsøking med bemerkelsesverdig presisjon.
Claude Fable 5.1 er bygget for uovervåkede agentarbeidsflyter som varer flere timer. Den er designet for å kjøre utvidede løkker uten å miste fokus eller avvike logisk, og den utmerker seg til å orkestrere komplekse verktøykjeder, repo-omfattende migreringer og test- og reparasjonssykluser over natten på egenhånd.
Best for
Claude Opus 5.5 utmerker seg ved interaktiv feilsøking med høy innsats, fra å isolere unnvikende produksjonsregresjoner i terminalen til å veilede raske refaktoreringer med flere filer sammen med utviklere. Claude Fable 5.1 er bygget for praktiske ingeniørmaratoner, og håndterer uanstrengt repo-omfattende avhengighetsoppgraderinger og kjører uovervåkede test- og reparasjonsløkker over natten uten avvik.
GPT-6 Astra (OpenAI)
GPT-6 Astra ble lansert av OpenAI i september 2026 og fungerer som flaggskipets kraftverk for teknisk problemløsning med høy innsats. Utstyrt med et kontekstvindu på 1,05 millioner token og en utdatagrense på 128K, kombinerer den omfattende kodebaseforståelse med OpenAIs mest strenge resonneringsarkitektur til dags dato.
Innen programvareutvikling er Astras definerende fortrinn ren algoritmisk disiplin og presisjon under press. I stedet for bare å produsere standardløsninger, utmerker de seg i å navigere i matematisk kompleks logikk, løse opp i flertrådede samtidighetsfeil og systematisk fange opp unnvikende kanttilfeller på tvers av forretningskritiske systemer.
Best for
Driftskritiske systemer og algoritmiske oppgaver med nulltoleranse. Ingeniørteam bruker det til å bygge tilpassede kryptografiske primitiver, finjustere distribuerte tilstandsmaskiner og jakte på unnvikende samtidighetsfeil i sentral finansiell eller betalingsinfrastruktur.
Gemini 4 Argon (Google)
Gemini 4 Argon ble utgitt av Google i oktober 2026, og fungerer mindre som en enkel kodeassistent og mer som en autonom systemarkitekt, bygget for å utforske, resonnere gjennom og omstrukturere komplekse databaser med minimal veiledning.
Dens enestående fordel er ren skala: et kontekstvindu på 1 million token kombinert med en banebrytende utdatagrense på 1 million token. Dette lar Argon innta hele kodebaser samtidig og utføre massive refaktoreringer, migreringer av eldre monolitter og dyp feilsøking på tvers av tjenester i en enkelt, uavbrutt omgang.
Best for
I praksis utmerker den seg i krevende ingeniøroppgaver som å løse opp store, eldre monolitter og utføre fullstendige språkmigreringer for hele systemet. Takket være den enorme gjennomstrømningen kan den spore komplekse feil på tvers av tjenester og levere komplette refaktoreringer av flere filer i én omgang.
Beste LLM for koding: Open Source Frontier Models
Å holde kodebasen privat betyr ikke lenger at du må gå på akkord med kapasitet. Nedenfor bryter vi ned tre fremragende kraftpakker innen åpen kompetanse, fra DeepSeek, Alibaba og Moonshot AI.
DeepSeek V4 Pro (DeepSeek)
Da DeepSeek lanserte DeepSeek V4 Pro i august 2026 under en MIT-lisens, tilbød den et ekte alternativ til modeller med inngjerdet hage. Levert med åpne vekter ga den ingeniørteamene intelligens i flaggskipklassen de kunne inspisere, finjustere og drifte på sine egne premisser – uten proprietær binding.
Ved tastaturet holder et vindu med 1 million tokens og en slank MoE-motor den skarp på tvers av vidstrakte databaser. Den isolerer regresjoner med flere filer med kirurgisk klarhet og driver uanstrengt selvhostede kodeagenter, noe som beviser at det å holde koden privat ikke lenger betyr at du må gå på akkord med kapasitet.
Best for
Luftgap i bedriftsmiljøer og regulerte bransjer der proprietær kode ikke kan berøre eksterne sky-API-er. Den er ideell for å drive private, selvhostede kodeagenter og utføre omfattende, automatiserte revisjoner på tvers av sensitive lokale databaser.
Qwen 3.8-Max (Alibaba)
Qwen 3.8-Max ble lansert av Alibaba i august 2026 og bringer intelligens i frontlinjeklassen til økosystemet for åpne vekter. Drevet av en 2,4T MoE-arkitektur som aktiverer bare 95 milliarder parametere over et vindu på 1 million tokens, kombinerer den dyp resonering med friheten til å distribuere og finjustere på dine egne premisser.
Innen programvareutvikling er dens definerende fortrinn kombinasjonen av autonom utførelse med innebygd visuell intelligens. Den trives i lukkede arbeidsflyter – den oversetter brukergrensesnittmodeller direkte til frontend-kode og driver terminalbaserte agentoppgaver med minimal menneskelig inngripen.
Best for
Multimodal frontend-generering og autonome, lukkede arbeidsflyter i selvhostede miljøer. Den utmerker seg ved å oversette visuelle UI/UX-design direkte til produksjonskode og drive terminalbaserte agenter gjennom komplette test- og reparasjonssykluser.
Kimi K3 (Moonshot AI)
Da Moonshot AI rullet ut Kimi K3 i juli 2026, taklet den den største svakheten ved åpen-vekt-koding: utholdenhet. Med 2,8T parametere over et vindu på 1 million tokens, klarer den å gjennomføre maratonmessige ingeniøroppgaver som vanligvis avsporer åpne modeller.
Ved koding fungerer den mindre som en autofullføringswidget og mer som en ekte autonom partner. K3 driver terminalverktøy, takler rotete refaktorering av flere filer og bruker innebygd visuell resonnering for å feilsøke UI-regresjoner i sanntid – med bemerkelsesverdig lite håndhold.
Best for
Maratonrefaktorering på tvers av massive kodebaser og terminaldrevne agentarbeidsflyter. Den utmerker seg ved langsiktige ingeniøroppgaver og visjonsstyrt UI-feilsøking med minimal menneskelig tilsyn.
HIX AI Chat Agent: Finn den beste LLM-en for koding
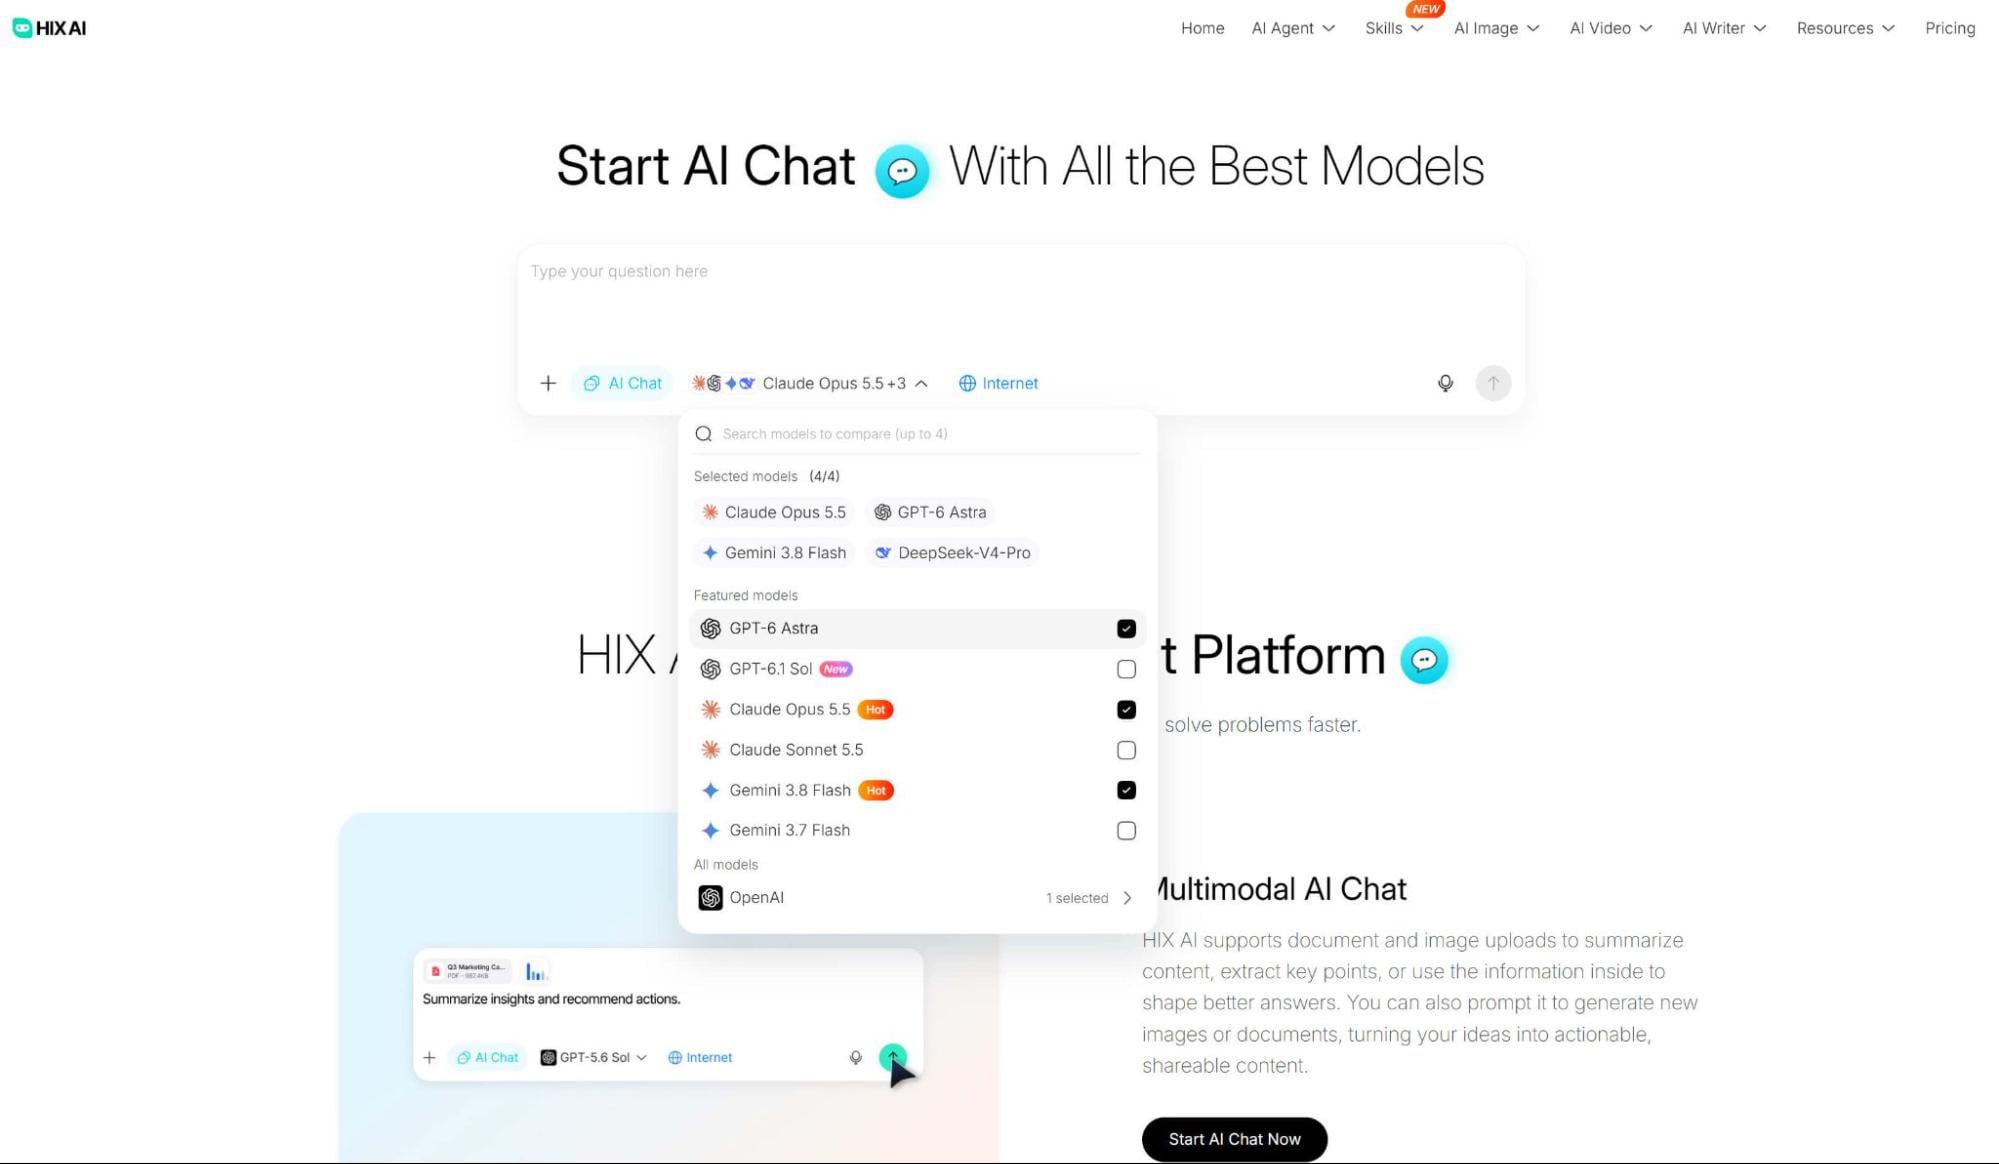
HIX AI Chat Agent forener frontmodeller – inkludert Gemini 4 Argon , Claude Opus 5.5 , Claude Fable 5.1 , GPT-6 Astra og Qwen 3.8-Max – i ett enkelt arbeidsområde. I stedet for å sjonglere fragmenterte abonnementer, får utviklere direkte tilgang til bransjens skarpeste resonneringsmotorer under ett tak.
Dens side-ved-side-sammenligningsmodus fjerner gjettingen fra modellvalg. Send inn en enkelt kodeprompt, kjør den på tvers av fire modeller samtidig, og inspiser logikken og kanttilfellene deres parallelt for å finne den beste LLM-en for koding på sekunder.
Like viktig er det at den lar deg rute oppgaver til hver motors naturlige optimale punkt. I stedet for å tvinge frem en universell arbeidsflyt, kan du tilordne Claude til systemarkitektur, bruke Qwen for generering av brukergrensesnitt til kode eller distribuere Gemini for omfattende kontekstbaserte kodebaserevisjoner.
Chat med HIX AI
Konklusjon
Realiteten er at det ikke finnes noen absolutt «beste LLM for koding». Ulike ingeniørutfordringer krever helt forskjellige styrker – fra rask frontend-prototyping til dyp arkitektonisk refaktorering. I stedet for å stole på en universell løsning, er den smarteste tilnærmingen å evaluere modeller mot din spesifikke arbeidsflyt for å finne den mest passende AI-modellen for koding.
HIX AI gjør den avgjørelsen enkel. Ved å la deg visuelt sammenligne svar på tvers av flere ledende modeller side om side, fjerner den gjettingen – og hjelper deg med å raskt finne den optimale løsningen for programmeringsoppgavene dine.