💡 Abstrakt
Da moderne Codierungsmodelle stark spezialisiert sind, gibt es kein einzelnes Tool, das für jeden Stack geeignet ist. Im Bereich proprietärer Lösungen zeichnet sich Claude Opus 5.5 durch interaktives Debugging aus, Claude Fable 5.1 steuert autonome, langlaufende Agenten, GPT-6 Astra bewältigt komplexe Parallelverarbeitung und Gemini 4 Argon ermöglicht dank seines enormen Durchsatzes umfangreiche Repository-Refactorings. Unter den Open-Source-Optionen ermöglicht DeepSeek V4 Pro die sichere Bereitstellung vor Ort, Qwen 3.8-Max übersetzt visuelle Designs in Code und Kimi K3 unterstützt Marathon-Refactorings. Die moderne Entwicklungsstrategie besteht nicht darin, sich für ein einzelnes Modell zu entscheiden, sondern Aufgaben dynamisch über einen Workflow mit mehreren Modellen zu verteilen.
Sich im heutigen unübersichtlichen Angebot an Lernmodellen zurechtzufinden und das beste Lernmodell für die Programmierung auszuwählen, kann schnell überfordernd wirken. Angesichts der Tatsache, dass jede neue Version eine zehnfache Produktivitätssteigerung verspricht, ist es keine leichte Aufgabe, herauszufinden, welches Modell die Erwartungen im eigenen Arbeitsalltag tatsächlich erfüllt.
Um Ihnen die Entscheidung zu erleichtern, stellt dieser Leitfaden sieben KI-Codierungsmodelle vor – darunter Gemini 4 Argon, Claude Opus 5.5, Claude Fable 5.1 und weitere. Indem wir ihre jeweiligen Stärken und idealen Anwendungsfälle erläutern, helfen wir Ihnen, das beste KI-Modell für Ihre spezifische Systemarchitektur zu finden.
Die besten LLM-Studiengänge für Programmierung
Die besten LLM-Studiengänge für Programmierung im Überblick
Um Ihnen bei der Auswahl des besten KI-Modells für die Programmierung zu helfen, zeigt die folgende Tabelle, wie die führenden Optionen von heute im Hinblick auf wichtige technische Benchmarks, Kontextgrenzen und ihre besten realen Anwendungsfälle abschneiden:
| Modelle | Am besten geeignet für | Kontextfenster | DeepSWE v1.1 | Terminalbank 4.0 | SWE-Atlas-Fragen und -Antworten |
|---|---|---|---|---|---|
| Claude Opus 5.5 | Vollständige Agenten-Workflows, CLI-Autonomie (Claude Code) und produktionsreife Fehlerisolierung | 1,0 Mio. | 68 | 60% | 66 |
| Claude Fable 5.1 | Über Nacht autonome Codierungsagenten, mehrstündige Tool-Orchestrierung und komplexe, repositoryweite Migrationen | 1,0 Mio. | 64 | 55% | 65 |
| GPT-6 Astra | Hochkomplexe algorithmische Entwicklung, tiefgreifendes Debugging von Parallelverarbeitung und Grenzfallanalyse | 1,05 Mio. | 68 | 60% | 62 |
| Gemini 4 Argon | Umfangreiche Repository-Migrationen, sprachübergreifende Neuentwicklungen und Refactoring monolithischer Codebasen | 1,0 Mio. | 79 | 57 % | 56 |
| DeepSeek V4 Pro | Spitzentechnologie zu einem Bruchteil der Kosten | 1,0 Mio. | 57 | 14% | 62 |
| Qwen 3.8-Max | Autonome mehrtägige Codierungsagenten und Büroproduktivität | 1,0 Mio. | 51 | 32 % | 62 |
| Kimi K3 | Frontend- und visuelle Programmierung | 1,0 Mio. | 68 | 13% | 66 |
Bester LLM für Programmierung: Proprietäre Frontier-Modelle
Für komplexe Architekturen und unternehmenskritischen Code bieten proprietäre Lösungen unübertroffene Präzision. Hier ein genauerer Blick auf vier branchenführende Modelle von Anthropic, OpenAI und Google.
Claude Opus 5.5 & Claude Fable 5.1(Anthropic)
Die von Anthropic entwickelten Systeme Claude Opus 5.5 und Claude Fable 5.1 repräsentieren zwei unterschiedliche Philosophien im modernen KI-Engineering: die eine ist auf die Echtzeit-Zusammenarbeit von Entwicklern ausgelegt, die andere auf die autonome Ausführung über einen langen Zeithorizont.
Claude Opus 5.5 glänzt als ultimatives interaktives Pair-Programming-Tool. Bekannt für seine branchenführende Terminal-Kompetenz und sein architektonisches Denkvermögen, brilliert es in Umgebungen mit Entwickler-in-the-Loop-Anbindung wie Claude Code – und überzeugt durch präzise Fehlerisolierung, dynamisches CLI-Refactoring und blitzschnelles Debugging in der Produktion mit bemerkenswerter Genauigkeit.
Claude Fable 5.1 wurde für unbeaufsichtigte, mehrstündige Agenten-Workflows entwickelt. Es ist darauf ausgelegt, lange Schleifen auszuführen, ohne den Fokus zu verlieren oder logisch abzuweichen, und eignet sich hervorragend für die eigenständige Orchestrierung komplexer Toolchains, repoweiter Migrationen und nächtlicher Test- und Reparaturzyklen.
Am besten geeignet für
Claude Opus 5.5 glänzt bei der interaktiven Fehlersuche in kritischen Situationen – von der Isolierung schwer auffindbarer Produktionsfehler im Terminal bis hin zur Unterstützung von Entwicklern bei schnellen, mehrteiligen Refaktorierungen. Claude Fable 5.1 ist für automatisierte Entwicklungsmarathons konzipiert und bewältigt mühelos Abhängigkeitsaktualisierungen im gesamten Repository sowie unbeaufsichtigte, nächtliche Test- und Reparaturschleifen ohne Abweichungen.
GPT-6 Astra(OpenAI )
GPT-6 Astra , im September 2026 von OpenAI veröffentlicht, gilt als Flaggschiff unter den KI-Systemen für die Lösung komplexer technischer Probleme. Ausgestattet mit einem Kontextfenster von 1,05 Millionen Token und einem Ausgabelimit von 128.000 Token kombiniert es umfassendes Codeverständnis mit der bisher rigorossten Logikarchitektur von OpenAI.
Astras entscheidender Edge in der Softwareentwicklung liegt in seiner ausgeprägten algorithmischen Disziplin und Präzision unter Zeitdruck. Anstatt lediglich Standardcode zu generieren, zeichnet es sich durch seine Fähigkeit aus, mathematisch komplexe Logik zu bewältigen, Fehler in Multithreading-Umgebungen aufzudecken und systematisch schwer fassbare Edge in unternehmenskritischen Systemen zu erkennen.
Am besten geeignet für
Missionskritische Systeme und algorithmische Aufgaben mit Null-Toleranz. Entwicklungsteams nutzen es, um maßgeschneiderte kryptografische Primitive zu erstellen, verteilte Zustandsautomaten zu optimieren und schwer auffindbare Parallelitätsfehler in der Kerninfrastruktur von Finanz- oder Zahlungssystemen aufzuspüren.
Gemini 4 Argon(Google )
Gemini 4 Argon, das von Google im Oktober 2026 veröffentlicht wurde, fungiert weniger als einfacher Code-Assistent, sondern eher als autonomer Systemarchitekt, der entwickelt wurde, um komplexe Repositories mit minimaler Anleitung zu erkunden, zu analysieren und umzustrukturieren.
Der herausragende Vorteil liegt in seiner enormen Skalierbarkeit: ein Kontextfenster von 1 Million Token gepaart mit einem bahnbrechenden Ausgabelimit von 1 Million Token. Dadurch kann Argon ganze Codebasen auf einmal verarbeiten und umfangreiche Refaktorierungen, Migrationen monolithischer Legacy-Systeme sowie tiefgreifendes serviceübergreifendes Debugging in einem einzigen, unterbrechungsfreien Durchlauf durchführen.
Am besten geeignet für
In der Praxis bewährt es sich besonders bei anspruchsvollen Entwicklungsaufgaben wie der Entflechtung komplexer Legacy-Systeme und der Durchführung vollständiger Sprachmigrationen. Dank seines enormen Durchsatzes kann es komplexe, serviceübergreifende Fehler aufspüren und vollständige, mehrteilige Refaktorierungen in einem einzigen Durchlauf durchführen.
Bester LLM für Programmierer: Open-Source-Frontier-Modelle
Die Geheimhaltung des Quellcodes bedeutet nicht länger, dass man auf Leistungsfähigkeit verzichten muss. Im Folgenden stellen wir drei herausragende Open-Source-Lösungen von DeepSeek, Alibaba und Moonshot AI vor.
DeepSeek V4 Pro(DeepSeek )
Mit der Veröffentlichung von DeepSeek V4 Pro im August 2026 unter der MIT-Lizenz bot DeepSeek eine echte Alternative zu proprietären Modellen. Dank der offenen Gewichtung erhielten Entwicklerteams erstklassige Intelligenz, die sie nach ihren eigenen Vorstellungen überprüfen, optimieren und hosten konnten – ohne proprietäre Abhängigkeiten.
An der Tastatur sorgen ein Fenster für eine Million Token und eine schlanke MoE Engine für optimale Leistung auch in umfangreichen Repositories. Sie isoliert Regressionen in mehreren Dateien mit höchster Präzision und unterstützt mühelos selbstgehostete Codierungsagenten. Damit beweist sie, dass die Geheimhaltung des Codes nicht länger mit Leistungseinbußen verbunden sein muss.
Am besten geeignet für
Es eignet sich für abgeschottete Unternehmensumgebungen und regulierte Branchen, in denen proprietärer Code keine externen Cloud-APIs berühren darf. Es ist ideal für den Betrieb privater, selbstgehosteter Codierungsagenten und die Durchführung umfassender, automatisierter Audits sensibler On-Premise-Repositories.
Qwen 3.8-Max (Alibaba)
Qwen 3.8-Max, im August 2026 von Alibaba eingeführt, bringt modernste Intelligenz in das Open-Weights-Ökosystem. Basierend auf einer 2,4-T MoE Architektur, die lediglich 95 Milliarden Parameter in einem Zeitfenster von einer Million Token aktiviert, vereint es tiefgreifende Analysen mit der Freiheit, es nach eigenen Vorstellungen bereitzustellen und zu optimieren.
In der Softwareentwicklung liegt sein entscheidender Edge in der Kombination von autonomer Ausführung und nativer visueller Intelligenz. Es eignet sich hervorragend für geschlossene Arbeitsabläufe – es übersetzt UI-Mockups direkt in Frontend-Code und steuert terminalbasierte Agentenaufgaben mit minimalem menschlichen Eingriff.
Am besten geeignet für
Multimodale Frontend-Generierung und autonome, geschlossene Workflows in selbstgehosteten Umgebungen. Es zeichnet sich durch die direkte Umsetzung visueller UI/UX-Designs in Produktionscode und die Steuerung terminalbasierter Agenten durch umfassende Test- und Reparaturzyklen aus.
Kimi K3 (Moonshot AI)
Als Moonshot AI im Juli 2026 Kimi K3 einführte, ging das Unternehmen die größte Schwäche der Open-Weights-Codierung an: die Ausdauer. Mit 2,8 Billionen Parametern in einem Zeitfenster von einer Million Token bewältigt Kimi K3 mühelos komplexe Entwicklungsaufgaben, die offene Modelle typischerweise zum Scheitern bringen.
Beim Programmieren agiert es weniger wie ein Autocomplete-Widget, sondern vielmehr wie ein vollwertiger, autonomer Partner. K3 steuert Terminal-Tools, bewältigt komplexe Refactorings mit mehreren Dateien und nutzt native visuelle Analyse, um UI-Regressionen in Echtzeit zu debuggen – und das mit bemerkenswert wenig Unterstützung.
Am besten geeignet für
Marathon eignet sich hervorragend für Refactoring in umfangreichen Codebasen und terminalgesteuerten Agenten-Workflows. Es zeichnet sich durch seine Fähigkeit aus, langfristige Entwicklungsaufgaben zu bewältigen und UI-Debugging mithilfe von Bildverarbeitungstools mit minimalem menschlichen Eingriff zu ermöglichen.
HIX AI Chat-Agent: Finden Sie den besten LLM für Programmierung
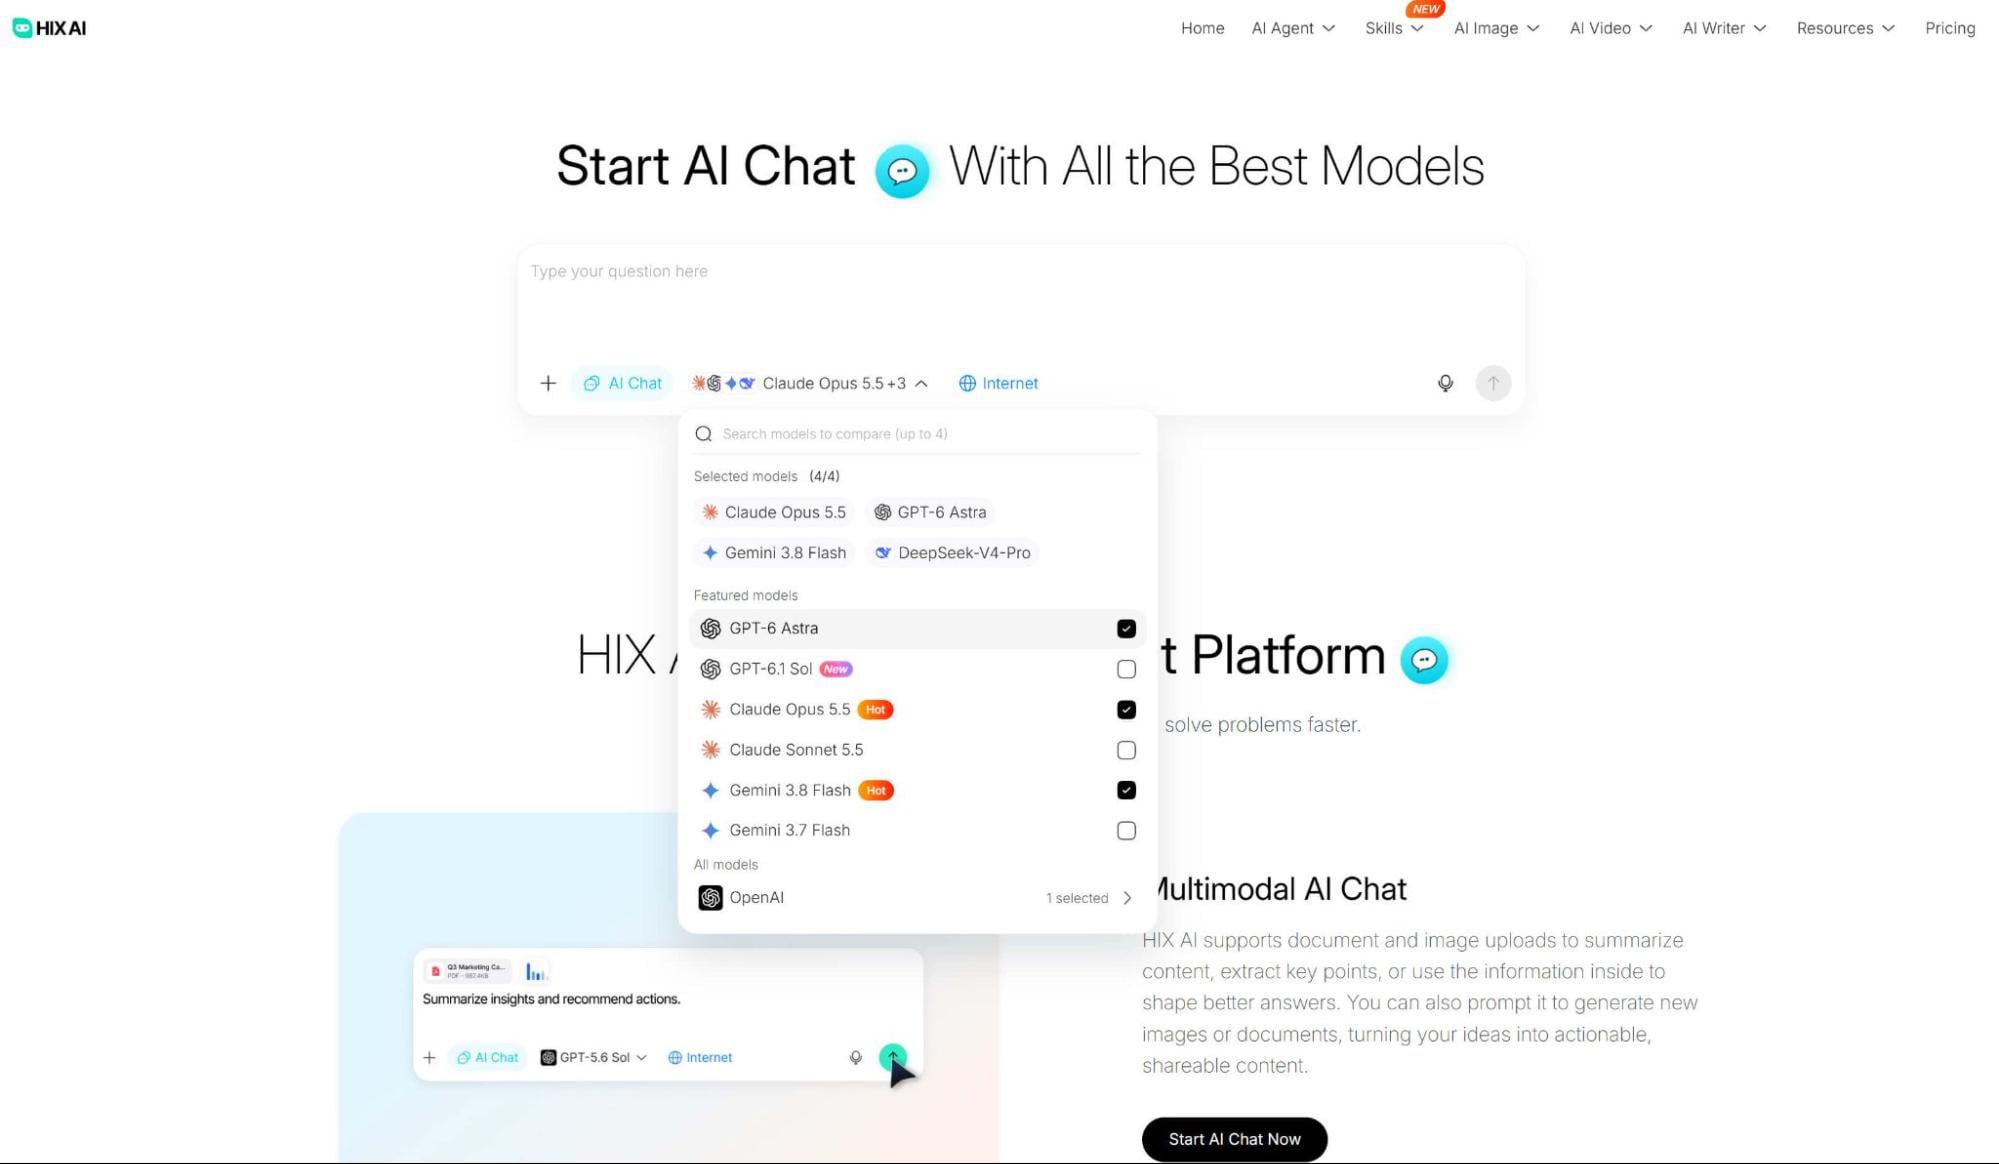
Der HIX AI Chat Agent vereint führende KI-Modelle – darunter Gemini 4 Argon ,Claude Opus 5.5 , Claude Fable 5.1 , GPT-6 Astra und Qwen 3.8-Max – in einem einzigen Arbeitsbereich. Anstatt mit fragmentierten Abonnements zu jonglieren, erhalten Entwickler direkten Zugriff auf die leistungsstärksten KI-Algorithmen der Branche – alles unter einem Dach.
Der Vergleichsmodus vereinfacht die Modellauswahl. Geben Sie eine einzige Programmieraufgabe ein, lassen Sie sie gleichzeitig auf vier Modelle anwenden und prüfen Sie deren Logik und Edge parallel, um in Sekundenschnelle das beste LLM für die Codierung zu ermitteln.
Genauso wichtig ist, dass Sie Aufgaben genau dem jeweiligen Anwendungsbereich der Engine zuweisen können. Anstatt einen einheitlichen Workflow zu erzwingen, können Sie beispielsweise Claude für die Systemarchitektur einsetzen, Qwen für die UI-zu-Code-Generierung nutzen oder Gemini für umfangreiche Codebasis-Audits verwenden.
Chatten Sie mit HIX AI
Abschluss
Tatsächlich gibt es kein absolut „bestes LLM fürs Programmieren“. Unterschiedliche technische Herausforderungen erfordern völlig unterschiedliche Stärken – von der schnellen Frontend-Prototypentwicklung bis hin zum tiefgreifenden Architektur-Refactoring. Anstatt sich auf eine Universallösung zu verlassen, ist es am sinnvollsten, Modelle anhand des eigenen Workflows zu evaluieren, um das am besten geeignete KI-Modell für die Programmierung zu finden.
HIX AI macht diese Entscheidung kinderleicht. Indem es Ihnen ermöglicht, die Ergebnisse mehrerer führender Modelle visuell miteinander zu vergleichen, beseitigt es das Rätselraten und hilft Ihnen, schnell die optimale Lösung für Ihre Programmieraufgaben zu finden.